 La tua Casa
 Rocksolid
 Kraft Fliesen
KI-Crawler lesen deine Website für zwei ganz verschiedene Zwecke: um Sprachmodelle zu trainieren und um Fragen in ChatGPT, Gemini oder der Google-Suche live zu beantworten. Die kurze Antwort auf die Frage, ob du sie sperren solltest: Trainings-Crawler darfst du sperren, ohne dass du in der Suche verlierst. Die Crawler, die Antworten bauen, solltest du als Unternehmen in aller Regel zulassen, sonst fehlst du dort als Quelle.
Was KI-Crawler sind und warum es zwei Sorten gibt
Ein Crawler ist ein Programm, das Websites automatisch abruft. Googlebot macht das seit Jahrzehnten für die Suche. Mit den KI-Assistenten sind neue Crawler dazugekommen, und die großen Anbieter trennen sie inzwischen nach Zweck. OpenAI etwa betreibt GPTBot, der Inhalte für das Training künftiger Modelle sammelt, und OAI-SearchBot, der Websites für die Suche in ChatGPT erfasst. Dazu kommt ChatGPT-User für Abrufe, die ein Nutzer im Gespräch selbst auslöst (vgl. [3]).
Diese Trennung ist der wichtigste Punkt des ganzen Themas. OpenAI schreibt ausdrücklich, dass jede Einstellung unabhängig von den anderen gilt: Du kannst OAI-SearchBot zulassen, um in den Suchergebnissen von ChatGPT zu erscheinen, und gleichzeitig GPTBot sperren, damit deine Inhalte nicht ins Training gehen (vgl. [3]). Wer alle KI-Bots in einen Topf wirft, trifft deshalb fast immer eine schlechtere Entscheidung als nötig.
Was das EuGH-Gutachten zu Gemini sagt
Am 3. November 2026 hat Generalanwalt Maciej Szpunar am Gerichtshof der EU seine Schlussanträge im Verfahren C-250/25 vorgelegt. Geklagt hat der ungarische Verlag Like Company gegen Google Ireland, weil Gemini Zusammenfassungen seiner Artikel ausgegeben hatte. Es ist das erste Verfahren am EuGH zu generativer KI und Urheberrecht (vgl. [1]).
Das Gutachten zieht dieselbe Linie wie die robots.txt. Das Training von Sprachmodellen mit geschützten Artikeln hält Szpunar für erlaubt, gedeckt durch die Ausnahme für Text und Data Mining. Anders sieht es aus, wenn ein Chatbot einen Artikel abruft, daraus eine Antwort baut und sie dem Nutzer zeigt: Dann kann das Recht des Presseverlags verletzt sein (vgl. [1]). Nach dem Bericht von RTÉ nennt er dafür zwei Fälle: wenn der Chatbot Bezahlschranken oder andere technische Sperren umgeht und wenn er die Ausdrucksform der Veröffentlichung erkennbar übernimmt (vgl. [2]). Geschützt ist dabei nur, wie ein Text formuliert ist, nicht die Fakten darin (vgl. [1]).
Ein Urteil ist das noch nicht. Die Schlussanträge binden das Gericht nicht, es folgt ihnen aber oft, und die Entscheidung wird in den kommenden Monaten erwartet (vgl. [1]). Google verweist in seiner Reaktion auf die Steuerungsmöglichkeiten, mit denen Rechteinhaber widersprechen können (vgl. [2]). Dieser Beitrag ersetzt keine Rechtsberatung.
Was das für dein Unternehmen heißt
Das Leistungsschutzrecht, um das es im Verfahren geht, gilt für Presseverlage. Für einen Handwerksbetrieb, eine Kanzlei oder einen Maschinenbauer ist die Lage eine andere: Du willst in aller Regel, dass ChatGPT oder Googles KI-Übersichten deine Leistungen kennen und deine Seite als Quelle nennen. Genau darum geht es bei der Sichtbarkeit in KI-Antworten. Wie stark KI-Antworten schon heute Klicks aus der klassischen Suche abziehen, haben wir im Beitrag über Google AI Overviews und sinkende Klicks beschrieben.
Für das Training gibt es in Deutschland einen klaren Hebel. Nach § 44b des Urheberrechtsgesetzes ist Text und Data Mining nur zulässig, wenn der Rechteinhaber es sich nicht vorbehalten hat, und bei Inhalten im Netz zählt dieser Vorbehalt nur in maschinenlesbarer Form (vgl. [7]). Das Gesetz schreibt kein Format vor. Die großen Anbieter dokumentieren für ihre Trainings-Crawler aber selbst die robots.txt als Weg zum Widerspruch (vgl. [3], [4]). Wem die Inhalte an KI-Texten gehören, die du selbst erzeugst, ist eine andere Frage, dazu mehr im Beitrag Urheberrecht bei KI-Inhalten.
KI-Crawler blockieren oder zulassen: die Entscheidung
Am Ende sind es zwei getrennte Fragen. Die erste: Sollen deine Texte in das Training künftiger Modelle eingehen? Die zweite: Sollen KI-Assistenten deine Seiten abrufen dürfen, wenn sie eine konkrete Frage beantworten? Für die meisten Unternehmen ist die zweite Frage die wichtigere, denn genau dort entscheidet sich, ob du in einer Antwort genannt und verlinkt wirst.
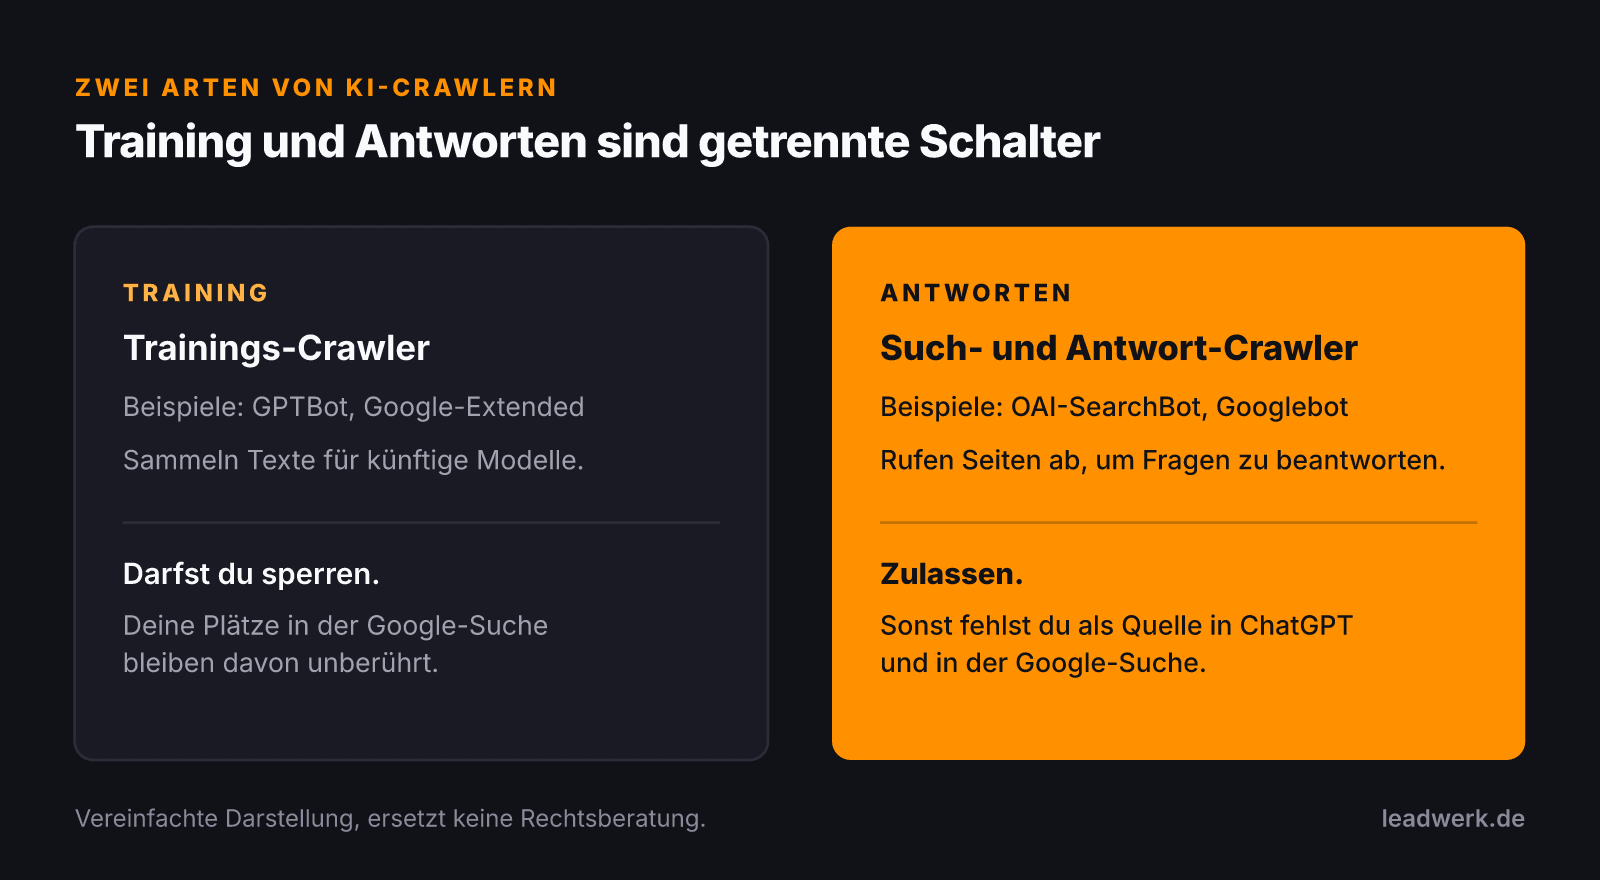
Das Training zu sperren, ist eine Abwägung ohne eindeutige Antwort. Dafür spricht, dass du die Kontrolle über deine Texte behältst. Dagegen spricht, dass Modelle aus dem Training lernen, wofür eine Marke steht. Belastbare Messungen, wie stark das die spätere Sichtbarkeit beeinflusst, kennen wir nicht. Wer viel eigenes Fachwissen veröffentlicht, das er verkauft, sperrt eher. Wer vor allem gefunden werden will, lässt es meist offen.
Die Crawler für Antworten zu sperren, ist dagegen fast immer ein Eigentor. Sperrst du OAI-SearchBot, gibst du die Suche in ChatGPT als Kanal auf. Sperrst du Googlebot, verschwindest du aus der Google-Suche insgesamt, denn KI-Übersichten und KI-Modus nutzen denselben Crawler wie die normale Suche (vgl. [5]).
So setzt du es in der robots.txt um
Die robots.txt liegt unter deinedomain.de/robots.txt. Für jeden Crawler legst du dort fest, was er darf. Diese Kennungen solltest du kennen:
- GPTBot: sammelt Inhalte für das Training der Modelle von OpenAI. Sperren verhindert das Training, nicht die Suche in ChatGPT (vgl. [3]).
- OAI-SearchBot: erfasst Websites für die Suche in ChatGPT. Zulassen, wenn du dort als Quelle erscheinen willst (vgl. [3]).
- Google-Extended: steuert, ob Google deine Inhalte für das Training von Gemini und für Antworten in den Gemini-Apps nutzt. Laut Google wirkt das weder auf die Aufnahme in die Google-Suche noch auf das Ranking (vgl. [4]).
- Googlebot: der normale Suchcrawler. Er bleibt offen. Was in KI-Übersichten aus deiner Seite gezeigt wird, steuerst du wie bei normalen Snippets über nosnippet, data-nosnippet oder max-snippet (vgl. [5]).
Ein Eintrag zum Sperren des Trainings bei OpenAI besteht aus zwei Zeilen: „User-agent: GPTBot“ und darunter „Disallow: /“. Für Google-Extended gilt dasselbe Muster. Prüfe danach, dass keine Regel für alle Crawler („User-agent: *“) aus Versehen mehr sperrt als gewollt. Welche Fehler in der robots.txt sonst Rankings kosten, zeigt unser Beitrag zu technischem SEO.
Achtung: Sperren, von denen du nichts weißt
Viele Websites sperren KI-Crawler, ohne dass es jemand entschieden hat. Cloudflare blockiert KI-Crawler seit dem 1. Juli 2025 standardmäßig für jede neu eingerichtete Domain, Websitebetreiber müssen den Zugriff also aktiv erlauben (vgl. [6]). Läuft deine Seite über Cloudflare, lohnt ein Blick in die Einstellungen zu Bots und KI-Crawlern. Ähnliche Schalter bringen manche Sicherheits- und SEO-Plugins für WordPress mit.
Das Tückische daran: Eine solche Sperre fällt in keinem Ranking auf. Die Seite steht bei Google wie gewohnt, nur in den Antworten von ChatGPT oder Perplexity taucht sie nie auf. Welche Seiten ChatGPT bevorzugt als Quelle heranzieht, beschreibt unser Beitrag zu ChatGPT SEO und den Quellen von ChatGPT.
Wie du prüfst, ob deine Inhalte in KI-Antworten ankommen
Eine offene robots.txt ist die Voraussetzung, aber noch keine Garantie. Ob du in KI-Antworten genannt wirst, hängt auch davon ab, ob deine Seiten die Fragen deiner Kunden klar beantworten und ob sie Belege liefern, die ein Assistent zitieren kann. Wie das aussieht, zeigt unser Beitrag Website für KI optimieren.
Prüfen lässt sich das mit wenig Aufwand: typische Fragen deiner Kunden in ChatGPT, Gemini und Perplexity stellen und festhalten, wer genannt wird. Wie du das regelmäßig und vergleichbar machst, steht im Beitrag KI Sichtbarkeit prüfen. Wir gehen bei unserer eigenen Website genau so vor. Wenn du das nicht allein aufsetzen willst, unterstützen wir dich als GEO Agentur in Karlsruhe dabei, deine Sichtbarkeit in KI-Antworten zu messen und gezielt auszubauen.
Quellen:
[1] The Next Web: EU court adviser says Google’s Gemini may infringe press copyright (03.11.2026). thenextweb.com (abgerufen November 2026).
[2] RTÉ News: EU court adviser backs publishers in AI case vs Google (04.11.2026). rte.ie (abgerufen November 2026).
[3] OpenAI: Overview of OpenAI Crawlers. developers.openai.com (abgerufen November 2026).
[4] Google Search Central: Übersicht über Google-Crawler und -Fetcher (Google-Extended). developers.google.com (abgerufen November 2026).
[5] Google Search Central: KI-Funktionen und deine Website. developers.google.com (abgerufen November 2026).
[6] Cloudflare: Pressemitteilung zur Standardsperre für KI-Crawler (01.07.2025). cloudflare.com (abgerufen November 2026).
[7] Urheberrechtsgesetz § 44b: Text und Data Mining. gesetze-im-internet.de (abgerufen November 2026).
Lässt deine Website die richtigen KI-Crawler rein?
In 15 Minuten schauen wir gemeinsam auf deine robots.txt und deine Einstellungen bei Hoster und Cloudflare: was KI-Crawler heute bei dir dürfen und ob du in den Antworten von ChatGPT und Google als Quelle auftauchst.