 La tua Casa
 Rocksolid
 Kraft Fliesen
Technisches SEO entscheidet, ob Google deine Seiten überhaupt findet, lesen und in den Index aufnehmen kann. Die meisten Fehler sind unsichtbar: Die Seite sieht für Besucher ganz normal aus, aber ein falscher Statuscode, eine vergessene Sperre oder ein Link, dem der Crawler nicht folgen kann, halten sie aus den Suchergebnissen heraus. Die gute Nachricht: Die häufigsten Fehler lassen sich mit wenig Aufwand finden und beheben.
Was technisches SEO ist und warum es zuerst kommt
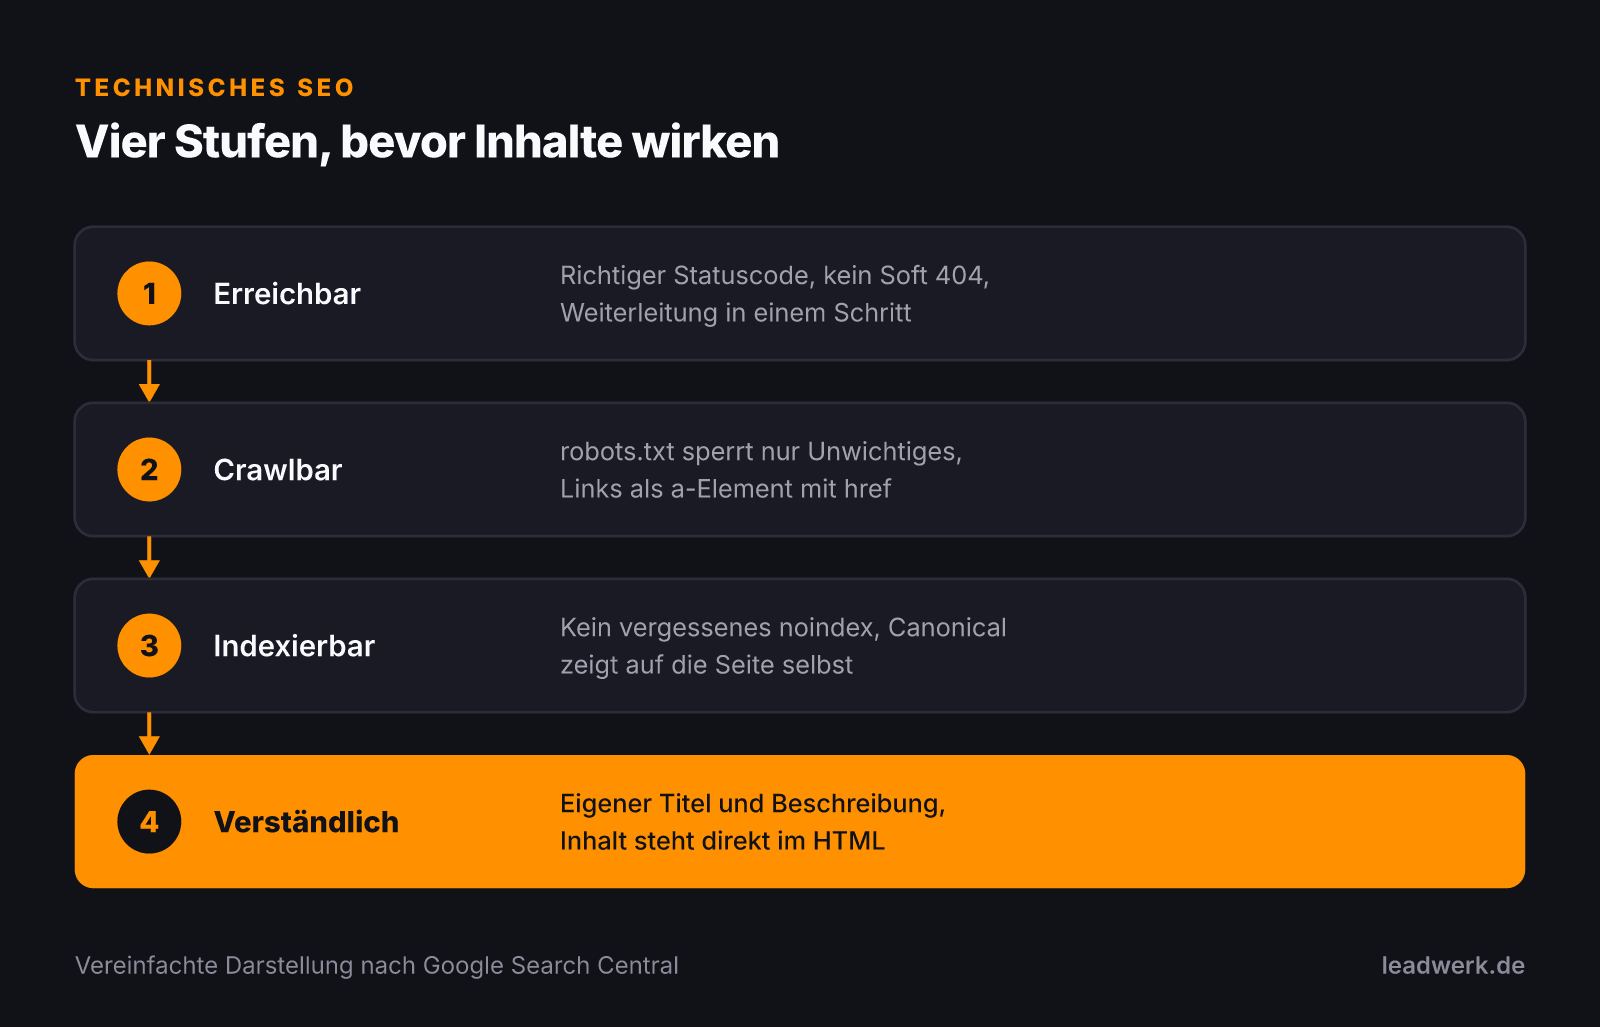
Bevor Google eine Seite für einen Suchbegriff einordnet, muss sie drei Stufen schaffen: Der Crawler muss sie erreichen, er muss sie lesen dürfen und er muss sie in den Index aufnehmen wollen. Technisches SEO kümmert sich um genau diese Stufen. Inhalte, Keywords und Backlinks wirken erst, wenn die Technik nicht im Weg steht.
Anlass für diesen Beitrag ist ein Leitfaden, den der Entwickler Saar Twito am 3. November 2026 bei freeCodeCamp veröffentlicht hat. Er zeigt acht technische Fehler, die er bei Website-Prüfungen immer wieder findet, und wie man sie mit Kommandozeilenwerkzeugen aufspürt (vgl. [1]). Wir haben die Liste für dich übersetzt: ohne Kommandozeile, dafür mit dem Blick darauf, was du selbst prüfen kannst und was in die Hände deiner Agentur gehört. Die Angaben zum Verhalten von Google haben wir in der offiziellen Dokumentation von Google Search Central nachgeprüft.
Fehler 1 und 2: falsche Statuscodes und Weiterleitungsketten
Ein Soft 404 ist eine Seite, die „nicht gefunden“ anzeigt, dem Server nach aber alles in Ordnung meldet, also den Statuscode 200 statt 404 liefert. Google erkennt solche leeren oder fehlerhaften Seiten trotzdem und meldet sie in der Search Console als Soft 404 (vgl. [2]). Das Problem: Solche Seiten verbrauchen Aufmerksamkeit des Crawlers, und im schlimmsten Fall landet eine leere Seite im Index. Typisch sind ausverkaufte Produkte, gelöschte Stellenanzeigen oder Suchseiten ohne Treffer.
Weiterleitungsketten entstehen fast immer bei Relaunches. Aus /angebot wird /angebot-2025, daraus später /leistungen, und jede alte Adresse läuft über mehrere Stationen. Google folgt laut eigener Dokumentation bis zu zehn Weiterleitungen hintereinander (vgl. [2]). Darauf solltest du es nicht ankommen lassen: Jede Station kostet Ladezeit und Crawl-Aufwand. Leite jede alte Adresse direkt auf ihr endgültiges Ziel. Wie du einen Relaunch so planst, dass dabei keine Rankings verloren gehen, steht in unserem Beitrag zum Website Relaunch mit Strategie.
Fehler 3 und 4: robots.txt und versteckte noindex-Anweisungen
Die robots.txt sagt Crawlern, welche Bereiche sie nicht besuchen sollen. Eine zu breite Regel wie „Disallow: /blog“ sperrt nicht nur Entwürfe, sondern den ganzen Blog. Wichtig zu wissen: Die robots.txt ist nicht dafür da, Seiten aus Google herauszuhalten. Die Datei steuert das Crawlen, nicht die Indexierung (vgl. [4]). Wer eine Seite wirklich aus den Suchergebnissen nehmen will, braucht noindex.
Genau da liegt der zweite Fehler. Die Anweisung noindex kann als Meta-Tag im Quelltext stehen oder als HTTP-Header namens X-Robots-Tag mitgeschickt werden. Beides wirkt gleich (vgl. [3]). Den Header siehst du aber nicht, wenn du den Quelltext der Seite öffnest. So bleibt eine Sperre aus der Entwicklungsphase oft monatelang unbemerkt. Und noch ein Haken: Ist eine Seite per robots.txt gesperrt, sieht Google ihr noindex gar nicht, weil der Crawler die Seite nie lädt (vgl. [3]). Sperre und noindex gleichzeitig zu setzen, bewirkt also oft das Gegenteil des Gewollten.
- Nach jedem Livegang prüfen, ob die Sperre der Testumgebung wirklich entfernt ist, in WordPress auch die Einstellung „Suchmaschinen davon abhalten, diese Website zu indexieren“.
- In der robots.txt nur Pfade sperren, die wirklich niemand finden soll, etwa interne Suchergebnisse oder Entwürfe.
- Seiten, die aus dem Index sollen, mit noindex versehen und für den Crawler offen lassen.
Fehler 5 und 6: Canonical, Titel und Beschreibung
Das Canonical-Tag sagt Google, welche Adresse die Hauptfassung einer Seite ist, wenn derselbe Inhalt unter mehreren Adressen erreichbar ist. Google behandelt diese Angabe als starkes Signal, nicht als Befehl (vgl. [7]). Schädlich wird es, wenn das Canonical auf eine fremde Seite zeigt, etwa wenn alle Leistungsseiten per Vorlage auf die Startseite verweisen. Dann bittest du Google, deine Leistungsseiten zu ignorieren. Im Normalfall verweist jede Seite auf sich selbst.
Titel und Beschreibung sind das, was Menschen in den Suchergebnissen von dir sehen. Doppelte Titel wie „Leistungen | Firma“ auf fünf Seiten machen es Google schwer, die richtige Seite zur Suche zu zeigen, und Suchenden schwer, sich für dich zu entscheiden. Fehlt die Beschreibung, baut Google selbst einen Ausschnitt aus dem Seitentext (vgl. [8]), der selten verkauft. Jede wichtige Seite braucht einen eigenen Titel mit dem Begriff, für den sie gefunden werden soll, und eine Beschreibung mit Nutzen. Wie die Seite danach aufgebaut sein sollte, damit aus dem Klick eine Anfrage wird, zeigt der Beitrag zum idealen Aufbau einer Landingpage.
Fehler 7 und 8: Links und Inhalte, die Google nicht lesen kann
Google folgt verlässlich nur Links, die als a-Element mit href-Attribut gebaut sind. Elemente, die nur per Skript auf einen Klick reagieren, etwa ein span mit onclick oder ein a ohne href, kann Google laut Dokumentation nicht zuverlässig auswerten (vgl. [5]). Für Besucher funktioniert so ein Menü einwandfrei. Für den Crawler endet die Website auf der Startseite. Das betrifft vor allem individuell programmierte Menüs, Filter und Kacheln.
Ähnlich ist es mit Inhalten, die erst per JavaScript nachgeladen werden. Google rendert solche Seiten mit einem Browser, aber erst, wenn Kapazität frei ist, und das kann dauern. Google selbst empfiehlt deshalb weiterhin serverseitiges Rendern oder Vorrendern, weil es die Seite für Menschen und Crawler schneller macht und nicht jeder Bot JavaScript ausführt (vgl. [6]). Das gilt auch für die Crawler von KI-Diensten. Warum es sich lohnt, für sie lesbar zu sein, beschreibt unser Beitrag Website für KI optimieren.
Technisches SEO selbst prüfen: so gehst du vor
Für einen ersten Check brauchst du keine Kommandozeile. Die wichtigsten Werkzeuge sind kostenlos, und mit dieser Reihenfolge findest du die meisten Fehler in einer Stunde:
- Search Console öffnen und unter „Seiten“ nachsehen, welche Adressen nicht indexiert sind und warum. Soft 404, „durch noindex ausgeschlossen“ und „durch robots.txt blockiert“ stehen dort mit Beispielen.
- Deine fünf wichtigsten Seiten mit dem URL-Prüftool der Search Console testen. Es zeigt, ob die Seite indexierbar ist, welches Canonical Google gewählt hat und wie die gerenderte Seite aussieht (vgl. [9]).
- Die robots.txt unter deinedomain.de/robots.txt aufrufen und jede Disallow-Zeile hinterfragen.
- Alte Adressen aus dem letzten Relaunch aufrufen und schauen, ob sie in einem Schritt am richtigen Ziel ankommen.
- In den Suchergebnissen mit site:deinedomain.de nach doppelten oder nichtssagenden Titeln suchen.
Wer eine WordPress-Seite betreibt, findet viele dieser Einstellungen im SEO-Plugin, etwa Canonical, noindex und Titelvorlagen. Dort entstehen aber auch viele Fehler, weil eine Vorlage auf alle Seiten wirkt. Was WordPress als System dafür mitbringt, liest du in unserem Beitrag über die Vorteile von WordPress als CMS.
Was technische SEO-Fehler mit deinen Anfragen zu tun haben
Technische Fehler kosten selten auf einen Schlag alle Rankings. Der Schaden kommt leise: eine Leistungsseite, die nie in den Index kommt, ein Ratgeber, dessen Canonical auf die Startseite zeigt, ein Menü, über das Google deine Unterseiten nicht findet. In Prüfungen für Websites, die wir übernehmen, sehen wir genau diese Muster immer wieder, besonders nach einem Relaunch oder einem Wechsel des SEO-Plugins. Das Ergebnis ist eine Website, die gut aussieht und trotzdem keine Anfragen aus der Suche bringt.
Deshalb fangen wir als SEO Agentur Karlsruhe jedes Projekt mit der Technik an, bevor wir über Inhalte und Keywords sprechen. Erst wenn Google jede wichtige Seite erreicht, lesen darf und richtig zuordnet, lohnt sich die Arbeit an Texten. Und wenn die Technik sitzt, ist auch die Ladezeit oft der nächste Hebel, dazu mehr im Beitrag zum passenden WordPress Cache Plugin.
Quellen:
[1] freeCodeCamp, Saar Twito: How to Find and Fix Common Technical SEO Issues on Your Website (03.11.2026). freecodecamp.org (abgerufen November 2026).
[2] Google Search Central: Wie HTTP-Statuscodes sowie Netzwerk- und DNS-Fehler die Google Suche beeinflussen. developers.google.com (abgerufen November 2026).
[3] Google Search Central: Indexierung mit noindex blockieren. developers.google.com (abgerufen November 2026).
[4] Google Search Central: Einführung in robots.txt. developers.google.com (abgerufen November 2026).
[5] Google Search Central: Crawlbare Links. developers.google.com (abgerufen November 2026).
[6] Google Search Central: Grundlagen der JavaScript-SEO. developers.google.com (abgerufen November 2026).
[7] Google Search Central: Doppelte URLs zusammenfassen (Canonical). developers.google.com (abgerufen November 2026).
[8] Google Search Central: Snippets in den Suchergebnissen. developers.google.com (abgerufen November 2026).
[9] Search Console-Hilfe: URL-Prüftool. support.google.com (abgerufen November 2026).
Findet Google deine wichtigsten Seiten?
In 15 Minuten schauen wir gemeinsam in deine Search Console: welche Seiten nicht im Index sind, woran es liegt und welche technischen Fehler du zuerst beheben solltest.